一站式AI数字人桌面应用AIGCPanel抛出v2.5.0版本,把过去让无显卡用户干瞪眼的云端语音能力真正接进了桌面。这次更新的核心很直白:只要在AI模型页的"其他模型"入口里填上火山引擎豆包语音或阿里云百炼DashScope的API Key,云端语音模型就能即刻上线,本地没有一张显卡的人,也能靠云端方案完成高质量语音合成。
填Key这一步被做得格外省心。软件在保存前会先拿一句"你好,这是一段语音试听。"合成一遍,接口真正通了才允许保存,免得用户事后在任务里翻错误日志找茬。这背后是一张由主进程维护的语音provider注册表:每个厂商只要把自己的HTTP接口适配成统一的soundTts调用就能接入。豆包语音走X-Api-Key鉴权,吐回来的是多段JSON拼接的单向流,软件得按分片解析再合并成完整音频;阿里云则走DashScope的qwen-tts,返回音频链接或base64数据。以后想加一家新厂商,写一个provider文件就够了。
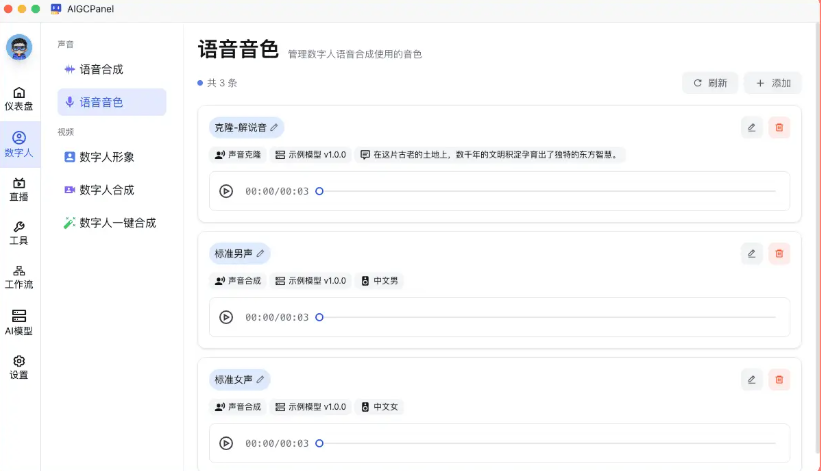
真正的变化在于"声音"被从散落各处的配置里收拢成了一套管得起来的体系。数字人侧叫"语音音色",直播侧叫"直播音色",两边各有各的库,都能添加声音合成或声音克隆音色,保存前直接试听。两套音色分表存储、互不干扰,声音克隆的参考音频要重新录或重新传,再配上对应文字,不再复用数字人那边的音色库——过去那种"这个克隆声音到底被谁带偏了"的扯皮,从此不再发生。添加弹窗右侧还贴心地放了使用说明:克隆显示录音要求,合成显示操作引导。
底层是一套VoiceService工厂加两个存储标识SoundVoice与LiveVoice。每条音色记录里存着类型、模型标识、参数和参考音频路径,试听和直播实时合成走的是同一条synthesize()调用链,效果完全一致。更妙的是直播换音色不用动直播服务:客户端对外只暴露一个带Voice:前缀的provider名,其余路由自己消化,以后新增音色,直播端一行代码都不用改。直播配置里优先用你选中的音色,没选就回退到旧的声音驱动配置,老用户的旧配置不会失效。
直播控制台这次也长了眼睛。顶部新增的"模型控制"区域能直接启动或停止直播模型、看清运行状态,旁边一个"模型日志"按钮点开就是实时日志。要是还没导入直播模型,这里会主动提示并一键跳到AI模型界面去导入。过去想确认"直播模型起没起来",得在几个页面之间来回切,现在一个区域看全,实现上也没另起炉灶:从模型列表里筛出带直播能力的记录,状态徽标和日志查看复用已有的组件。
界面细节被全面打磨。弹窗内容会自然撑高,小窗口下不再溢出屏幕;左侧导航选中项改成品牌蓝浅色底块,暗色模式同步调亮;禁用状态按钮改为浅灰底配中灰字,不再让人看不清。几个会咬人的bug也被焊死:通用模型任务在进程异常退出时曾被误判为成功,如今改为校验是否真正产出结果;部分错误提示在英文界面仍显示中文的旧毛病修好了;新版Windows上因执行wmic导致的报错也一并消除。
顺着这次升级,几个还在服役的老功能值得新用户认个脸。"可视化工作流"从v2.0.0起就能拖拽节点把大模型、脚本、工具箱串成流水线,支持断点续跑,复杂流程不用写代码;v2.4.0上线的"绿幕视频替换背景"和"歌曲翻唱"一个做抠像换背景、一个把歌曲人声换成指定音色,是发布后被问得最多的两块;v2.3.0的"API服务与接口"让同一条流水线除了点界面,也能通过HTTP接口调用,方便集成进自己的系统。从v2.0.0的工作流引擎、20+小工具与CLI,到v2.2.0的文生图生视频、v2.3.0的接口开放、v2.4.0的抠像与翻唱,再到这次v2.5.0把云端语音和音色管理收进一套体系,AIGCPanel的路线很清晰:把模型装一次,让声音能被反复调用。