小米宣布推出空间音频理解大模型 MiDashengLM-Spatial,完整公开模型权重及推理代码,并采用 Apache2.0开源许可证发布。小米称,该模型是业界首个开源的端到端空间音频理解大模型,在基础音频理解能力之上,进一步引入空间感知与推理能力。
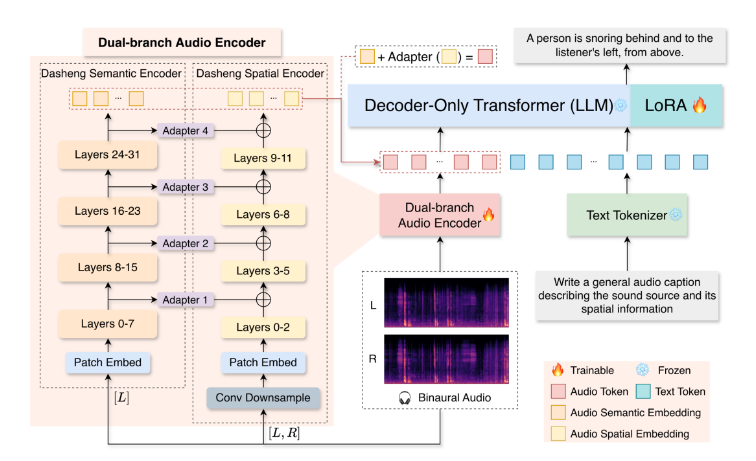
过去两年,小米先后开源声音基座模型 Xiaomi Dasheng 和声音理解大模型 MiDashengLM-7B,相关技术已在智能家居、汽车座舱等场景落地超过30项应用,支持对语音、环境声音及音乐进行统一感知与理解。
此次发布的 MiDashengLM-Spatial 以 MiDashengLM-7B 为基础,使模型不仅能够识别声音内容,还能判断声音来源及其空间分布,推动音频大模型从内容理解向空间感知拓展。
小米表示,MiDashengLM-Spatial 后续将陆续应用于智能家居、汽车座舱等场景,通过空间听觉能力提升「人车家全生态」的交互体验。此次开放模型权重与推理代码,也为开发者开展空间音频理解相关研究和应用开发提供了基础。相关测试数据尚待补充。
项目主页:https://jinbo-hu.github.io/midashenglm-spatial-demo/