AI音乐生成平台Suno推出Speech测试版,开始从歌曲创作拓展到口语音频。该功能可根据用户输入的想法、诗歌或完整文稿生成语音,并同时为其配上原创背景音乐。Suno称,Speech是首个能将语音和音乐作为一条完整音轨协同生成的音频模型。
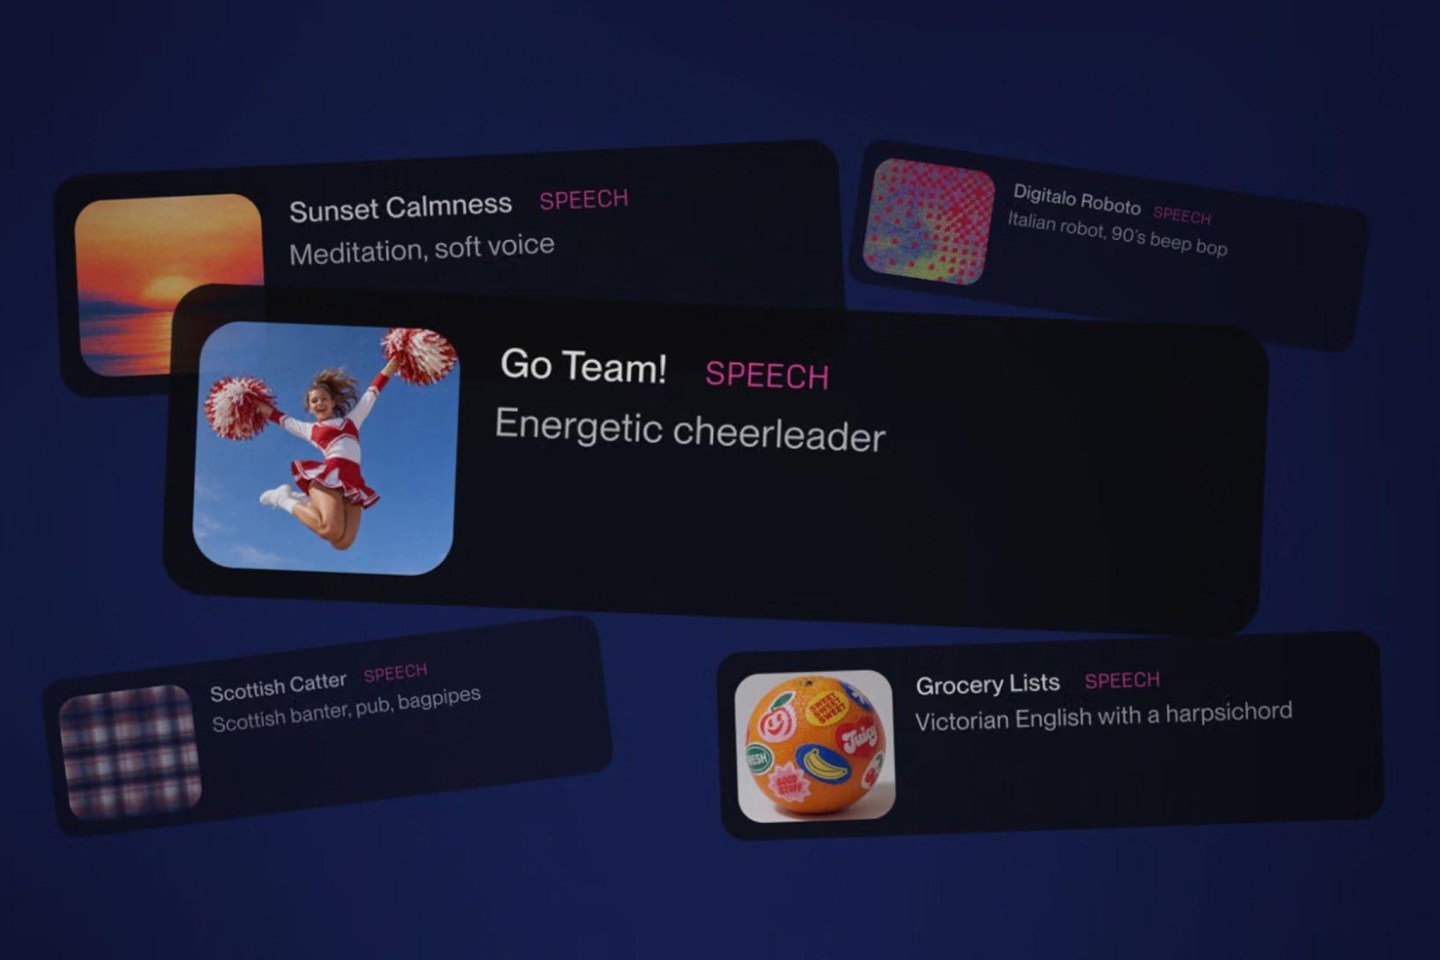
Speech已在Suno网页端和移动端开放测试,免费用户也可体验。用户可在“Create”创作页面选择Speech:简易模式允许用文字描述想要的内容,例如让海盗船长鼓舞船员;高级模式则可输入已经写好的脚本,并调整AI声音的性别、表达风格以及每次生成的变化程度。背景音乐可以关闭,用户也能只生成语音;单次音频最长约8分钟。
Suno表示,团队此前已小范围测试一个月,目前希望通过公开测试收集反馈并继续改进。公司首席产品官杰克·布罗迪称,音乐仍是Suno的核心,但平台也希望支持音乐之外的人类表达。公司举例称,Speech可用于为诗歌、冥想、鼓舞演讲或睡前故事制作朗读音频,也能把普通文字或语音留言变成带有戏剧性配乐的作品。
Suno也提醒,当前版本仍处于测试阶段,生成效果并不总是稳定,例如口音可能偏离设定,停顿和情绪表达也可能过于夸张。与已有的文字转语音工具相比,Speech的主要特点是将旁白与配乐一起生成;用户若只需要干净的语音,也可以关闭伴奏。