10月26日,据报道,Anthropic已向美国证券监管机构提交IPO文件。这家凭借Claude和编程工具迅速崛起的AI公司,终于走到了资本市场的聚光灯下。这本来应该是一个关于商业成功的故事。
过去几年,Anthropic逐渐成为企业级AI市场最受关注的公司之一。它在编程领域建立起优势,将模型能力嵌入开发者工作流,并向企业客户提供更高价值的服务。按照路透社披露的数据,Anthropic 2025年营收达到45.9亿美元,2026年上半年营收进一步增至162.9亿美元。
但招股文件同时揭开了另一面:2026年上半年,Anthropic净亏损达到807亿美元。其中,约724亿美元来自可转换票据公允价值变动,不反映现金流出。真实的经营亏损约为6.93亿美元。
但让投资者难以松口气的是,Anthropic在招股书中给出了未来十年至少5180亿美元的算力采购承诺,其中约八成不可取消或无论使用量均需支付。
本次IPO,Anthropic计划募资1000亿美元,自成立至今,Anthropic已经合计融资了1500亿美元。
美股市场本就对人工智能基础设施的巨额支出表现出了担忧,Anthropic的上市更是催动了市场脆弱的神经。
业内人士评价,此次上市事关重大,如果进展不顺,整个市场都会受到拖累。
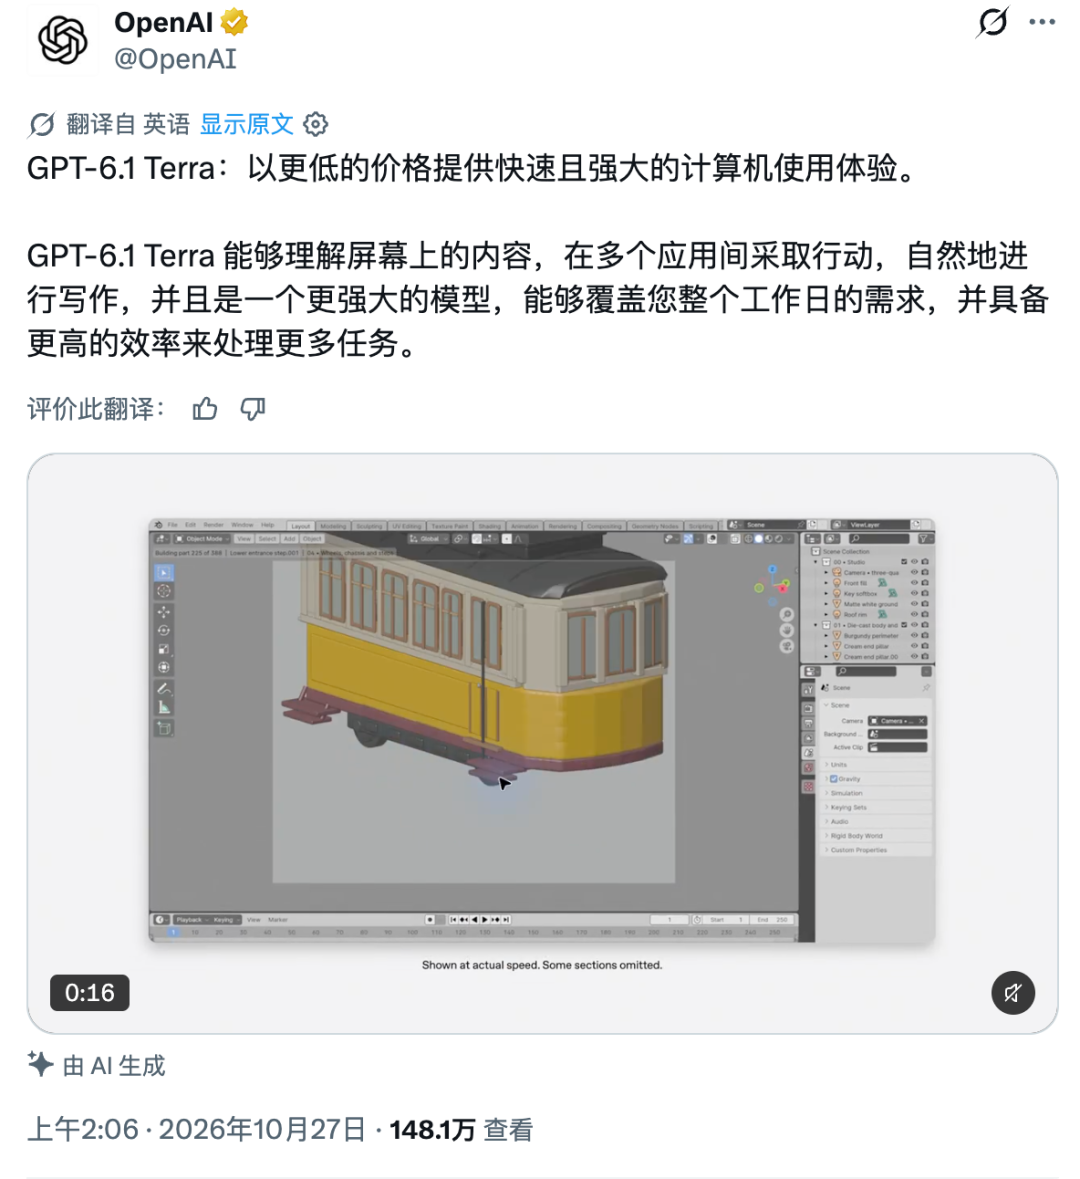
一度在追随Anthropic的OpenAI近期也频频转向,一方面是转向低价型模型,10月26日,OpenAI又发布了新一代中端模型GPT-6.1 Terra,将更低的调用价格与计算机操作能力作为重要卖点。
在大洋此岸,始终主打性价比路线的DeepSeek连续多次上调了本轮融资计划,最新消息称其新一轮融资超过了1000亿元,并已经大刀阔斧的走在了大扩张的道路上。多位知情人士向凤凰网科技透露,DeepSeek最近团队扩张势头很猛,“总要把融到钱的花到合理的地方”,而融资越多,也意味着DeepSeek要做的事情越多。
全球AI竞赛正在前所未有的激烈。
商业化样板Anthropic,巨亏807亿美元
在全球AI行业,Anthropic一直是一个颇具代表性的参照系。
与主要依赖消费级流量的产品不同,Anthropic从编程和企业服务切入,逐渐建立起自己的商业路径。Claude在开发者群体中积累了用户,企业客户则通过API调用、付费订阅等方式购买模型能力。模型不只是一个聊天窗口,而是进入软件开发、知识处理和业务流程的生产工具。
这条路的吸引力很直接:企业愿意为能够提高生产效率的工具付费,而且高价值场景通常拥有比普通消费者应用更清晰的付费逻辑。
尤其在编程领域,AI的价值不再仅仅体现在回答问题是否准确,而在于能否完成代码编写、调试、测试和复杂任务执行。对于企业来说,如果模型可以缩短开发周期、减少重复劳动,付费便有了相对具体的依据。
一位AI赛道CEO在与凤凰网科技交流时,会认为Anthropic是AI商业模式的重要样本,“大家一开始发现AI coding有很强的商业化转化能力,这最早也来自于Anthropic,现在Anthropic又开始做AI制药,未来肯定也会有人跟随”。
但收入的质量,与利润的质量,是两回事。
按照路透社对Anthropic招股文件的梳理,公司2025年经营亏损约80.6亿美元,2026年上半年经营亏损约6.93亿美元。其同期计算与基础设施支出接近90亿美元,较上年同期约23亿美元大幅增加。
这意味着,Anthropic的业务确实在快速扩张,但支撑业务扩张的资源成本同样不容忽视。
模型公司卖出的每一个Token,都不是凭空产生的。训练需要算力,推理需要算力,用户规模扩大、任务复杂度提升,也会不断增加计算资源的消耗。尤其当AI从简单问答走向编程代理和复杂任务执行,模型可能需要更多轮推理、调用工具和反复校验,单次任务背后的成本结构也随之改变。
企业客户愿意付费,并不意味着这笔生意天然拥有足够高的利润率。若收入增长需要持续投入更多算力才能维持,规模扩大与盈利改善之间,就未必存在简单的正相关关系。
Anthropic面临的另一重压力,是长期算力采购承诺。路透社报道,公司已与多家合作伙伴签订规模巨大的云服务、计算资源和基础设施协议,未来十年的相关承诺超过5000亿美元。
Anthropic的经营并非毫无进展。相反,收入增长和企业客户扩张说明,市场正在为其模型能力付费。但让外界不解的是商业模式本身,当模型能力持续进步,推理成本能否同步下降?当更多工作交给AI,客户愿意支付的价格,能否覆盖模型、算力和服务交付的全部成本?
各种“链主”加持,始终开源的另一条路
如果说Anthropic代表的是从高价值场景切入、逐步建立商业收入的路线,那么DeepSeek带给行业的另一种启示,是成本本身也可以成为模型竞争力的一部分。
DeepSeek早期引发行业震动,重要原因之一就是它让市场重新审视了训练和使用大模型的成本。外界曾将注意力集中在其模型的性能表现,以及训练成本的相关披露上。但对商业化而言,比某一个训练数字更重要的,是低成本能否延伸到模型部署、推理和实际使用环节。
OpenRouter数据,在调用量方面,DeepSeek旗下模型已连续三周位居该平台周榜第一。此外,minimax、智谱与腾讯等模型也长期居于平台调用量前5。
DeepSeek的路线提供了一个值得研究的方向:模型能力并不只有不断增加参数、堆叠算力这一条实现路径。架构设计、训练方法、推理效率和资源调度,都可能影响最终的单位成本。
更重要的是,低成本会改变模型进入市场的方式。
这将是截然不同的两种发展思路。
美国国土安全部近期下令联邦机构全面移除DeepSeek产品及基于其模型开发的第三方服务,而DeepSeek几乎同时宣布将内部推理框架DeepInfer全面开源,兼容英伟达与华为昇腾两大算力平台。戏剧的对比背后,指向的是同一个事实:DeepSeek已经被摆在了全球AI竞争的前排,而它选择的应对方式不是收缩,是把技术底座铺得更开。
近期,多家媒体报道,DeepSeek即将完成约1000亿元人民币融资。从9月开始,这轮融资的规模就在一路被“追高”:最初计划500亿,中途上调到800亿,最终落在1000亿。加上6月首轮约510亿元,DeepSeek在半年内累计吸金约1500亿元,投前估值维持在5000亿元人民币。
投资阵容空前豪华,据自媒体《金钱的潮汐》统计,本轮融资汇集了超过20家投资机构,上一轮老股东IDG资本、拾象科技、正心谷资本、Monolith、宁德时代、腾讯以及国智投等机构继续参与本轮融资。新进投资方则包括中国移动、中国电信、国寿投资、兆易创新旗下的石溪资本、中芯聚源、博裕资本、CPE源峰、高榕资本、君联资本、中信投资、美团龙珠、横店资本、吉利资本等机构。另据了解,本轮融资吸引了大量上市公司及产业资本间接参与,其中包括牧原股份、知乎、世纪华通、完美世界、巨人网络、大华股份等,参与者之众,难以一一列举。
不难看出,梁文锋在选择投资人时尤为看重产业价值。比如,在能源方面有扎实储备宁德系、与国产存储芯片紧紧捆绑的兆易创新系。
在巨额的投资面前,DeepSeek也正面临着“花钱”的烦恼。一位接近DeepSeek的人士告诉凤凰网科技,DeepSeek正在给投资人规划一个新的增长路线,其中就包括大举扩充团队。
6月首轮约510亿元融资刚落定,DeepSeek就在6月25日发布招聘公告,明确提出“将所有部门规模扩大至少一倍”,一次性开放33个岗位,覆盖技术研发、算力基础设施、产品落地、前沿算法研究、综合职能七大板块。甚至在乌兰察布招揽数据中心基建岗位。
到了9月,DeepSeek Harness团队负责人崔添翼在社交平台一次性放出约150个招聘名额,用他的原话说,需求是“前所未有的”。对待员工福利,DeepSeek也堪称大手笔,有消息称,DeepSeek给清华大学姚班一名实习生开出的税前日薪达到5500元,月薪超过12万元;校招核心系统研发工程师岗位的月薪区间则在6万至9万元。
但梁文锋却始终保持着朴素与低调,一位接近DeepSeek人士告诉凤凰网科技,DeepSeek的办公地主要是北京和杭州,而梁文锋长期在北京租房子住,且房间布置一直非常简单。
性价比开始主导一切
在众多AI巨头里,OpenAI一直是最摇摆的那个。
他们最初追求模型智能的上限,还一度想要拿下C端市场,甚至幻想过要做“AI时代的微信”连接一切。
但在巨额的亏损与被反超的收入面前,OpenAI又一度学起了Anthropic,在AI coding领域攻城略地,以期更好的商业化转化。
如今,OpenAI的做法又越来越DeepSeek。今年9月23日,GPT-6 Sol与Luna同时发布,Luna的API输入价被打到每百万token 0.1美元,堪称地板价。
半个月后的10月7日,OpenAI把Luna直接推给免费用户,覆盖ChatGPT全量人群;付费用户拿Sol,免费用户拿Luna。
10月26日发布的GPT-6.1 Terra,定位于OpenAI的中端模型序列,侧重计算机操作和日常办公任务。其API标准价格较前代GPT-5.6 Terra降低50%;OpenAI还宣称,在部分任务测试中,Terra能够以远低于旗舰模型的成本完成工作。
不过有业内人士认为,“OpenAI仍在摇摆阶段, 从他们在做具身智能模型就能看出来,相比于Anthropic,OpenAI很多时候很摇摆,但很快也会被市场教育,去做能赚钱的生意”。
毕竟,大模型市场的卷有目共睹,如果不能持续建立优势做好主页,很快就会昙花一现。